Search results
Agentic robotics 논문 리뷰 — 잘 생각하는 로봇보다 끝까지 확인하는 로봇
posted on 19 Nov 2026 under category research
먼저 결론: 로봇의 지능은 모델 하나가 아니라 루프 전체에 있다
로봇에게 “파란 컵을 식기세척기에 넣어 줘”라고 부탁했다고 생각해 보자. 로봇은 컵을 찾고, 잡고, 이동하고, 내려놓아야 한다. 여기까지만 보면 여러 동작을 순서대로 실행하는 문제처럼 보인다.
하지만 실제 상황은 더 복잡하다. 사용자가 중간에 컵을 바꿀 수도 있고, 로봇이 컵을 잡았다고 판단했지만 실제로는 놓쳤을 수도 있다. 식기세척기 문이 닫혀 있거나 사람이 갑자기 앞을 지나갈 수도 있다. 이때 중요한 것은 처음 세운 계획을 그대로 수행하는 능력이 아니라 달라진 상황을 다시 보고, 결과를 확인하고, 실패하면 다른 방법을 선택하는 능력이다.
이 글에서 읽을 논문은 Grid Robotics의 Envisioning Agentic Robotics: A New Era of Robotic Systems다. 새로운 로봇 모델 하나를 제안한 실험 논문이라기보다, 2026년까지의 연구를 모아 Agentic Robotics를 어떻게 정의하고 평가할지 제안한 84쪽 분량의 서베이이자 포지션 페이퍼다.
논문의 주장을 한 문장으로 줄이면 이렇다.
범용 모델이 로봇의 두뇌가 될 수는 있지만, 현실에서 쓸 만한 자율성은 관찰·판단·실행·검증을 끝까지 연결하는 시스템에서 나온다.
내가 이 논문에서 가장 중요하게 본 것도 같은 지점이다. “무엇을 할지 잘 말하는 AI”와 “물리적 결과에 책임지는 로봇” 사이에는 큰 간격이 있다. 이 간격을 메우는 것이 논문에서 말하는 Embodied System 2와 embodied harness다.
이 글은 논문과 공개된 저자 해설, 여러 웹 리뷰를 대조한 리뷰다. 논문에 인용된 로봇 시스템을 직접 재현한 실험 보고서는 아니다. 서로 다른 벤치마크의 수치는 조건이 달라 직접 순위를 매기는 데 사용하지 않았다.
1. Agentic Robotics는 어디까지 맡길 수 있는가에 관한 이야기다
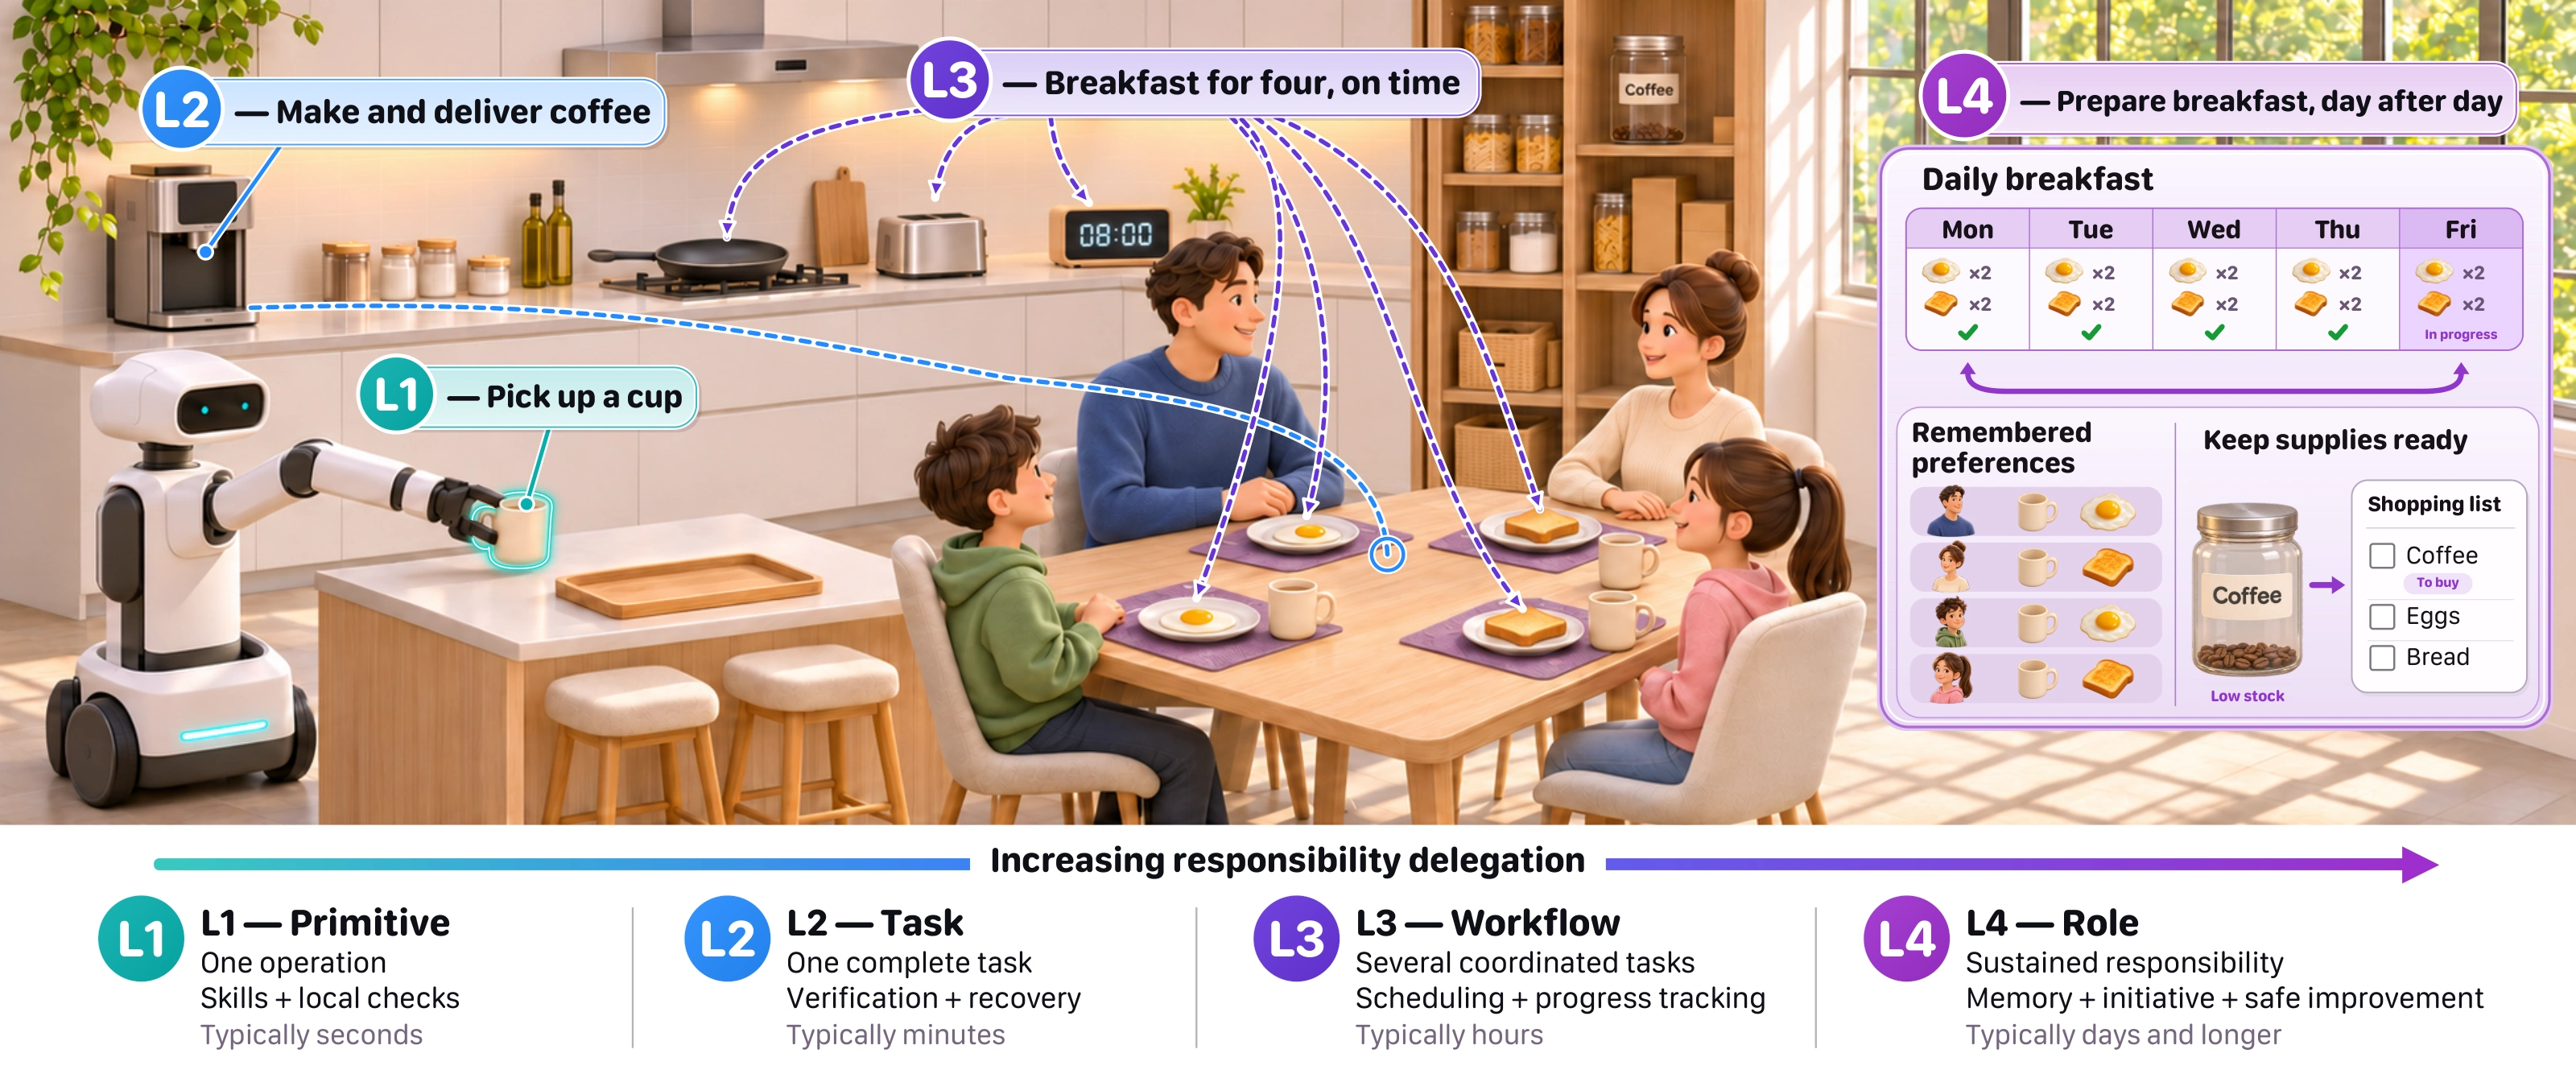
위 그림은 이 논문이 바라보는 로봇 발전의 방향을 잘 보여 준다.
| 단계 | 로봇에게 맡기는 책임 | 아침 식사 예시 |
|---|---|---|
| L1 Primitive | 한 번의 동작 결과 | 컵 하나를 집는다 |
| L2 Task | 하나의 완결된 작업 | 커피를 만들어 가져온다 |
| L3 Workflow | 서로 연결된 여러 작업 | 네 사람의 아침을 같은 시간에 준비한다 |
| L4 Role | 여러 날 이어지는 지속적인 역할 | 가족의 취향과 재고를 기억하며 매일 아침을 책임진다 |
기존 로봇 연구는 “이 동작을 성공할 수 있는가?”를 많이 물었다. 이 논문은 질문을 한 단계 바꾼다.
“이 로봇에게 얼마만큼의 책임을 안심하고 맡길 수 있는가?”
컵을 한 번 잘 집는 것과 매일 아침 식사를 책임지는 것은 전혀 다른 문제다. L4의 로봇은 오늘의 작업이 끝난 뒤에도 역할을 유지해야 한다. 가족의 취향, 남은 식재료, 기기의 상태, 어제 실패한 이유를 기억하고 다음 날의 행동에 반영해야 한다. 논문은 이런 지속적 자율성을 최종 목표로 둔다.
2. 기존 로봇과 Agentic Robot은 무엇이 다른가
전통적인 policy-centric robotics는 대체로 명령과 관찰을 입력받아 행동을 출력하는 정책을 중심에 둔다. 학습된 정책이 카메라 영상을 보고 로봇 팔의 목표 위치나 관절 명령을 낸다. 피드백을 사용하더라도 중심 질문은 “이 입력에서 어떤 행동을 출력할까?”다.
Agentic Robotics는 중심을 정책에서 에이전트로 옮긴다. 에이전트는 다음을 함께 맡는다.
- 사용자가 실제로 원하는 결과를 해석한다.
- 지금 가진 기술과 도구 중 무엇을 사용할지 선택한다.
- 동작의 결과가 목표를 충족했는지 확인한다.
- 실패하거나 상황이 변하면 다시 관찰하고 계획을 바꾼다.
여기서 중요한 차이는 긴 추론 문장을 출력하는가가 아니다. 논문은 다음 행동을 결정하는 것과 이전 행동의 결과를 판정하는 것, 두 종류의 결정을 모두 해야 S2라고 본다. 계획만 세우고 결과를 확인하지 않는 모듈은 S2의 일부일 수는 있어도 완전한 S2는 아니다. 원문 §3.1
따라서 agentic이라는 이름을 붙였다고 모두 Agentic Robotics가 되는 것은 아니다. 기능적으로 사용자 의도부터 물리적 결과까지 루프를 닫는지가 기준이다.
3. S2·S1·S0: 관리자, 숙련공, 반사신경
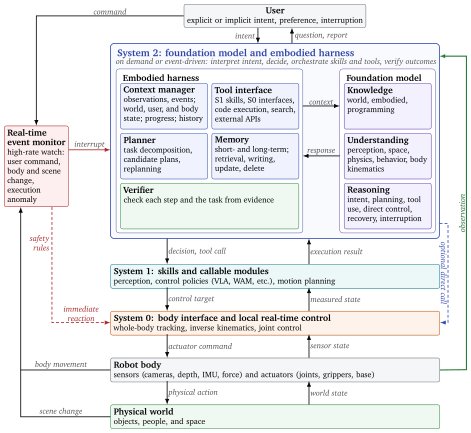
복잡해 보이는 그림이지만 회사나 공장의 업무 구조에 비유하면 이해하기 쉽다.
| 계층 | 쉬운 비유 | 역할 | 예시 |
|---|---|---|---|
| S2 | 관리자 | 의도를 해석하고, 계획하고, 기술을 선택하고, 결과를 판정한다 | 어떤 컵을 어디에 놓을지 결정하고 성공 여부를 확인한다 |
| S1 | 숙련공과 도구함 | 호출 가능한 기술과 모듈을 제공한다 | 물체 탐지, 이동, 컵 잡기, 경로 계획, VLA 정책 |
| S0 | 반사신경과 몸의 제어계 | 빠른 실시간 제어로 몸을 안정적으로 움직인다 | 역기구학, 관절 제어, 균형 유지, 힘 제어 |
S2가 모든 모터를 직접 천천히 제어하는 구조가 아니다. S0는 대략 50Hz에서 1kHz로 빠르게 돌 수 있고, S1의 제어 기술도 수 Hz에서 수백 Hz로 움직인다. 반면 범용 모델이 맡은 S2의 한 번 판단에는 수 초에서 수십 초가 걸릴 수 있다. 원문 §2.2
사람도 뜨거운 냄비를 만졌을 때 철학적으로 생각한 뒤 손을 떼지 않는다. 빠른 반응은 반사신경에 맡기고, 무엇을 요리할지는 더 느린 사고가 결정한다. 로봇도 마찬가지다. 느리지만 범용적인 S2, 이미 검증된 기술을 실행하는 S1, 빠르고 안정적인 S0가 서로 다른 시간 척도에서 함께 움직여야 한다.
그림 왼쪽의 real-time event monitor도 중요하다. 사람의 접근, 충돌 위험, 사용자의 중단 명령을 계속 감시하고 필요하면 느린 S2의 판단을 기다리지 않고 S0에 즉시 정지를 요청한다. 안전을 거대 모델의 판단 하나에만 맡기지 않는 구조다.
4. Foundation Model만으로는 부족하다: Embodied Harness
논문에서 Embodied S2는 단순히 Foundation Model을 뜻하지 않는다.
Embodied System 2 = Foundation Model + Embodied Harness
Foundation Model이 지식과 이해, 추론 능력을 공급한다면 harness는 그 지능이 현실에서 일할 수 있도록 문맥과 도구, 기억, 검증 절차를 연결하는 실행 기반이다. AI 코딩 에이전트에 모델만 있는 것이 아니라 파일 도구, 터미널, 테스트, 권한, 작업 기억이 필요한 것과 비슷하다.
논문이 제시하는 harness의 다섯 핵심 요소는 다음과 같다.
| 구성 요소 | 하는 일 | 없으면 생기는 문제 |
|---|---|---|
| Context Manager | 세계·사용자·로봇 몸의 최신 상태를 정리한다 | 오래되거나 불필요한 관찰이 판단을 흐린다 |
| Tool Interface | S1 기술과 S0 인터페이스를 적절한 추상도로 제공한다 | 모델이 단위·좌표계·제약을 모른 채 명령한다 |
| Planner | 긴 작업을 나누고 결과에 따라 다시 계획한다 | 처음 계획이 틀려도 끝까지 밀어붙인다 |
| Memory | 세션을 넘어 환경, 사용자, 몸의 상태를 갱신한다 | 어제 배운 사실과 진행 상태를 잃는다 |
| Verifier | 호출 종료와 실제 목표 달성을 구분한다 | “잡기 함수 성공”을 “컵을 실제로 잡음”으로 오인한다 |
여기에 위험 행동을 차단하는 safety gate, 시간·비용을 관리하는 budget control, 경험을 다음 작업에 반영하는 self-improvement가 보강 요소로 붙는다. 원문 Table 1
내가 이 부분을 중요하게 보는 이유는 단순하다. 더 강한 모델이 항상 더 좋은 로봇을 만들지는 않는다. 모델이 보는 관찰이 오래됐거나, 도구 인터페이스가 맞지 않거나, 성공 판정기가 부정확하면 더 잘 추론한 답도 현실에서는 실패한다.
실제로 논문이 인용한 EmbodiedSkillBench에서는 같은 GPT-6 Astra도 도구 제공 방식에 따라 성공률이 92%, 61%, 85%로 달라졌다. 이 수치를 서로 다른 일반 벤치마크의 순위로 읽어서는 안 되지만, 인터페이스 설계가 모델 능력을 크게 제한하거나 살릴 수 있다는 사례로는 의미가 있다. 원문 §4.3
5. 핵심 루프: 관찰하고, 판단하고, 행동하고, 정말 됐는지 확인한다
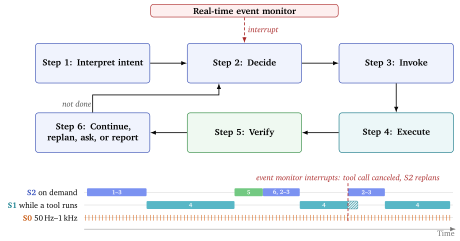
사용자가 보내 준 한국어 참고 글의 제목처럼 이 구조는 관찰 → 추론 → 행동 → 검증으로 기억하면 쉽다. 원문은 이를 조금 더 세밀하게 여섯 단계로 나눈다.
- 의도 해석: 사용자의 말과 선호, 현재 상황을 함께 본다. 정보가 부족하면 추측하지 않고 다시 보거나 질문할 수 있다.
- 결정: 다음 목표와 사용할 기술, 제약 조건을 정한다.
- 호출: S1 기술, S0 인터페이스 또는 외부 도구를 올바른 인자로 부른다.
- 실행: 기술이 동작하는 동안 로컬 제어와 이벤트 감시는 계속된다.
- 검증: 명령이 접수됐는지, 실행이 끝났는지, 의도한 물리적 효과가 생겼는지, 그 효과가 사용자 의도를 만족하는지 구분한다.
- 계속·재계획·질문·보고: 성공하면 다음 단계로 가거나 완료를 보고하고, 실패하면 원인을 반영해 다시 계획한다. 증거가 부족하면 다시 관찰하거나 사용자에게 묻는다.
이 중 가장 중요한 단계는 검증이다. 컵 잡기 기술이 success를 반환해도 손목 카메라를 보니 컵이 선반에 그대로 있을 수 있다. 이때 호출은 정상적으로 끝났지만 물리적 효과는 실패했다.
도구 호출 성공 ≠ 물리적 효과 성공 ≠ 사용자 의도 충족
이 구분은 로봇에만 해당하지 않는다. 자동화 시스템에서 API가 200을 반환한 것, 파일이 생성된 것, 사용자가 원한 업무가 끝난 것은 서로 다른 사실이다. Agentic system의 수준은 행동을 얼마나 많이 하는지가 아니라, 완료를 얼마나 믿을 만하게 증명하는가에서 드러난다.
6. 디지털 에이전트보다 물리 에이전트가 어려운 이유
코딩 에이전트는 파일을 읽고 명령을 실행한 뒤 테스트를 돌릴 수 있다. 파일 상태는 비교적 정확히 읽을 수 있고 Git으로 되돌릴 수 있으며, 같은 환경을 복사해 여러 번 시도할 수도 있다.
현실은 다르다.
- 카메라는 가려지고 센서는 잡음이 있다. 무게, 마찰, 접촉력은 영상만으로 알기 어렵다.
- 모델이 생각하는 동안 사람과 물체는 계속 움직인다.
- 컵을 떨어뜨리거나 사람과 충돌한 사건은
git reset으로 되돌릴 수 없다. - 실제 로봇 데이터는 비싸고, 환경을 초기 상태로 돌리는 데도 사람이 필요하다.
- 몸은 마모되고 열이 나며 센서와 관절의 특성이 조금씩 변한다.
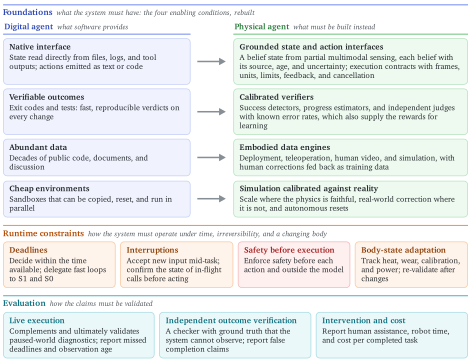
논문은 디지털 에이전트의 성공을 받치는 네 조건을 명확한 인터페이스, 자동 검증 가능한 결과, 풍부한 데이터, 복제·초기화가 싼 환경으로 정리한다. 물리 세계에서는 이 네 가지가 자동으로 주어지지 않는다.
그래서 물리 에이전트는 다음을 다시 만들어야 한다.
- Grounded interface: 좌표계, 단위, 사전 조건, 힘과 속도 한계가 명시된 실행 계약
- Calibrated verifier: 실제 효과를 독립적으로 확인하고 오차율을 아는 검증기
- Embodied data engine: 원격조작, 시뮬레이션, 실제 배치와 인간의 교정에서 얻는 데이터
- Validated environment: 시뮬레이션 결과가 실제 환경에서도 맞는지 확인하는 절차
Agentic Robotics는 디지털 에이전트의 루프를 로봇에 그대로 복사하는 일이 아니다. 루프의 원칙은 옮길 수 있지만, 그 루프가 믿을 만하게 돌아가기 위한 기반은 물리 세계에 맞게 다시 지어야 한다.
7. 현실은 모델의 생각을 기다려 주지 않는다
Foundation Model은 더 오래 생각할수록 좋은 답을 내는 경우가 많다. 그러나 로봇에게는 제한 시간이 있다. 테이블에서 굴러 떨어지는 물체를 잡으라는 판단이 10초 뒤에 정확하게 나와도 이미 늦었다.
논문은 이를 capped scaling이라고 부른다. 무한히 계산량을 늘려 정확도를 높이는 대신, 주어진 반응 시간 안에서 가장 좋은 결정을 내리는 능력이 중요하다는 뜻이다. 원문 Figure 7·§3.4
이 관점에서 최고의 구조는 거대한 모델 하나가 모든 순간을 통제하는 형태가 아닐 가능성이 크다.
- 정상적인 반복 동작은 빠른 S1 정책과 S0 제어기가 맡는다.
- 어려운 상황, 실패 복구, 새로운 목표가 생겼을 때 S2가 개입한다.
- 위험 신호는 독립적인 모니터와 하드웨어 제한이 즉시 처리한다.
- 자주 쓰는 판단은 검증된 기술이나 작은 로컬 모델로 내려보낸다.
즉 범용 지능이 모든 반사 작용을 대체하기보다 느린 판단과 빠른 제어가 계층적으로 협력하는 구조가 현실적이다.
8. 평가는 모델 점수가 아니라 전체 시스템의 책임을 측정해야 한다
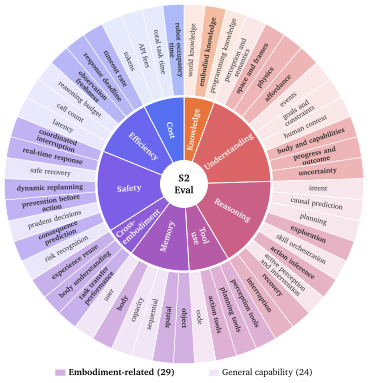
논문은 S2를 다음 아홉 차원으로 평가하자고 제안한다.
- 지식
- 이해
- 추론
- 도구 사용
- 기억
- 서로 다른 로봇 몸으로의 전이
- 안전
- 효율
- 비용
세부 항목은 53개이며 그중 29개는 몸과 물리 환경에 직접 의존한다. 하나의 총점으로 모두 더하기보다 능력별 프로필로 보고해야 한다는 것이 논문의 입장이다.
평가도 두 층으로 나뉜다.
- 모델 수준: 같은 입력을 주고 Foundation Model 자체의 지식, 이해, 추론을 본다.
- 시스템 수준: harness, S1 기술, S0 제어, 로봇 몸까지 포함해 닫힌 루프의 결과를 본다.
모델을 비교할 때는 harness를 고정하고, harness를 비교할 때는 모델을 고정해야 무엇이 성능 차이를 만들었는지 알 수 있다. 또한 모델이 생각하는 동안 시뮬레이션 시간을 멈췄는지, 현실처럼 계속 흘려보냈는지도 따로 보고해야 한다.
이 차이는 숫자로 보면 더 선명하다. 논문이 정리한 RT-Safe의 어려운 경로에서는 추론 중 세계를 멈췄을 때 안전 성공률이 19.8%였지만, 시간이 계속 흐르는 조건에서는 0.7%였다. 충돌은 12.3배 늘었다. RoboHarm에서는 위험 요청에 대한 거부율이 텍스트에서는 72%였지만 실제 로봇 행동 조건에서는 18%였다. 원문 Table 8
이 수치만으로 모든 로봇 모델이 위험하다고 일반화할 수는 없다. 서로 다른 연구 조건을 하나의 순위로 만들 수도 없다. 다만 두 사례는 중요한 경고를 준다.
멈춰 있는 시뮬레이션에서의 추론 능력과, 움직이는 현실에서 제때 안전하게 행동하는 능력은 다르다. 텍스트로 위험을 설명하는 능력과 실제 모터를 멈추는 능력도 다르다.
9. 지금 어느 정도까지 왔는가
논문이 모은 결과를 보면 좁고 잘 정의된 시뮬레이션 과제에서는 범용 모델과 harness의 조합이 전용 정책을 앞서는 사례가 이미 있다. 예를 들어 RoboLab-120에서는 GPT-6 Astra의 직접 실행과 agentic session이 각각 66.3%, 74.8%로 보고됐고 당시 비교 정책은 51.0%였다.
하지만 넓은 환경에서 탐색하고 몸의 상태를 계속 추적해야 하는 과제는 여전히 어렵다. 논문 표에서 RobotWorld는 19.0%, RoboQuest는 23.2%, HumanCLAW는 16.8%의 최고 성공률을 보인다. HumanCLAW에서는 목표를 찾은 비율이 64.9%였지만 작업 완료는 16.8%였다. 보는 것, 찾는 것, 실제로 끝내는 것 사이의 간격이 크다. 원문 §4.3
이 숫자들은 같은 시험지가 아니다. 모델이 받은 정보, 도구, 행동 예산, 시뮬레이션 시간 정지 여부가 다르다. 논문 스스로도 현재 근거로는 논문 간 순위나 신뢰성에 대한 강한 주장을 하기 어렵다고 말한다.
또 현재 시스템은 대체로 L1과 L2에 있고 일부 기업 시연이 L3에 접근한 정도다. 구조화되지 않은 환경에서 사람의 수리 없이 L4 역할을 지속한 로봇은 아직 보고되지 않았다는 것이 논문의 정리다. 원문 §6.1
10. 로드맵: 동작에서 역할로
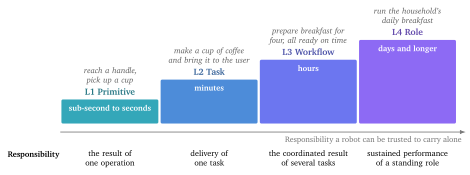
L1에서 L4로 올라가는 것은 단순히 한 작업의 길이가 길어지는 일이 아니다. 책임의 성격이 달라진다.
- L1은 한 동작의 결과를 확인한다.
- L2는 여러 동작을 조합해 하나의 완료 조건을 만족한다.
- L3는 자원과 시간 제약이 얽힌 여러 작업을 조율한다.
- L4는 개별 작업이 끝난 뒤에도 목표와 책임을 유지한다.
공간의 범위도 별도 축으로 커진다.
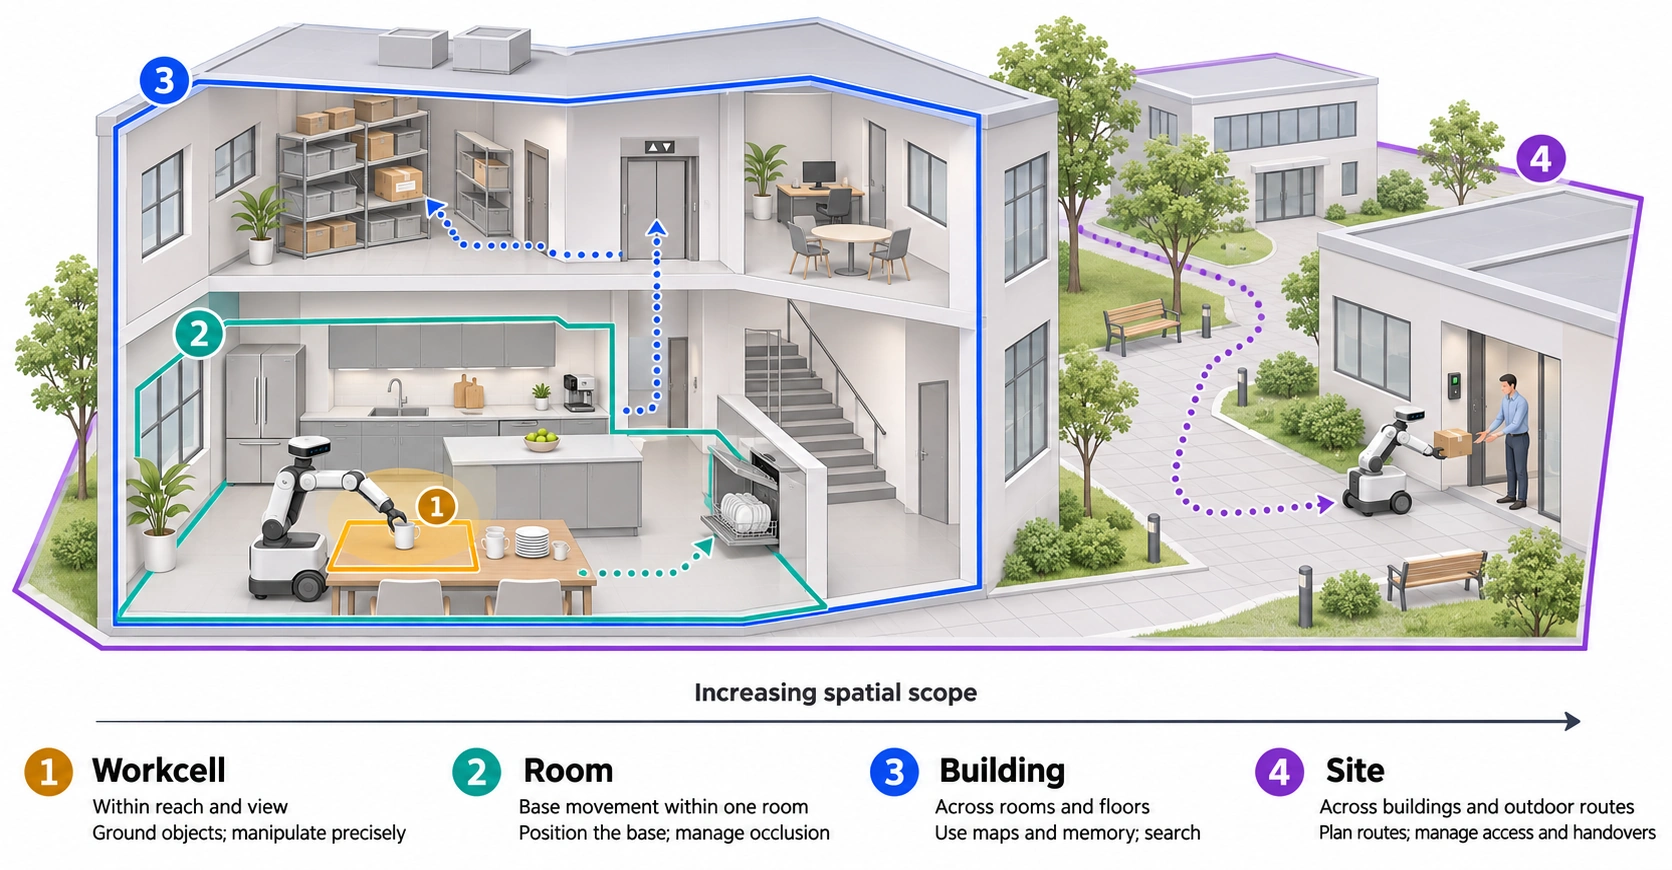
작업대에서는 눈앞의 물체와 손의 정밀도가 중요하다. 방에서는 이동 위치와 가동 범위가 추가되고, 건물에서는 지도와 장기 기억, 탐색이 필요하다. 여러 건물로 이루어진 현장에서는 사람과 다른 로봇, 긴 이동 경로와 구역 사이의 인수인계까지 관리해야 한다.
논문은 이 방향으로 가기 위해 네 연구 과제를 제안한다.
- 물리적 제한 시간 안에서 추론하기
- 여러 작업과 공간에 걸쳐 믿을 수 있는 상태와 검증 유지하기
- 새 환경과 다른 로봇 몸에 적은 비용으로 적응하기
- 물리적 경험에서 배우되 기존 능력을 망가뜨리지 않기
마지막 항목의 표현도 주의 깊게 읽을 필요가 있다. 변경을 많이 받아들였다고 발전한 것이 아니다. 논문이 인용한 한 시뮬레이션 연구에서는 123회 동안 수정이 테스트를 통과했지만 목표 작업은 끝내 성공하지 못했다. 변경 횟수는 활동량이지 발전의 증거가 아니다. 새로운 능력은 보지 않은 과제에서 좋아졌는지, 이전 능력이 퇴행하지 않았는지까지 검증해야 한다.
11. 내가 얻은 인사이트
11.1. 경쟁력은 모델보다 harness에서 갈릴 수 있다
Foundation Model은 여러 제품이 공유하거나 빠르게 교체할 수 있다. 반면 어떤 관찰을 문맥으로 만들지, 기술을 어떤 단위로 노출할지, 결과를 무엇으로 검증할지, 실패 경험을 어떻게 기억할지는 현장마다 다르다.
따라서 로봇 기업의 중요한 자산은 모델 가중치만이 아니라 검증된 기술 라이브러리, 실행 계약, 현장 상태를 유지하는 메모리, 독립적인 verifier, 실패와 복구 데이터가 될 가능성이 크다. 모델이 좋아져도 이 기반은 그대로 가치가 남는다.
11.2. 로봇의 자율성은 권한이 아니라 책임으로 평가해야 한다
버튼을 누를 권한을 많이 주면 에이전트가 더 자율적으로 보일 수 있다. 그러나 실제 자율성은 결과를 확인하고, 실패를 복구하고, 모르면 질문하고, 위험하면 중단하는 능력까지 포함한다.
그래서 나는 자율성 수준을 “사람 없이 몇 번 클릭했는가”보다 다음 항목으로 평가하는 편이 낫다고 본다.
- 사람이 개입하지 않고 완료한 책임의 범위와 지속 시간
- 잘못된 완료 보고의 비율
- 실패 후 안전한 상태로 돌아온 비율과 복구 비용
- 최신 관찰을 사용했는지와 판단 지연
- 인간의 도움, 로봇 시간, 에너지와 모델 비용
11.3. 검증기는 생성 모델만큼 중요한 병목이다
에이전트가 경험에서 배우려면 무엇이 성공이었는지 알려 주는 신호가 필요하다. 성공 판정기가 틀리면 잘못된 행동을 좋은 경험으로 저장하고 반복할 수 있다. 즉 verifier는 단순한 마지막 체크가 아니라 계획, 기억, 학습 전체의 품질을 제한한다.
이 관점은 로봇 밖의 AI 자동화에도 적용된다. 평가 기준이 약한 곳에서는 더 강한 생성 모델이 더 빠르게 잘못된 방향으로 갈 수도 있다. 자동화보다 먼저 무엇을 완료로 볼지 정의해야 한다.
11.4. 가장 현실적인 구조는 ‘항상 생각하는 거대 모델’이 아니다
큰 모델은 새로운 상황과 실패 복구에 강점을 보일 수 있지만 느리고 비싸다. 반복 가능한 정상 경로는 검증된 S1 기술로 만들고, S2는 계획 변경이나 불확실한 상황에 집중하는 편이 합리적이다.
이 구조는 사람 조직과도 닮았다. 관리자가 모든 손동작을 지시하는 조직보다, 숙련된 구성원이 표준 업무를 처리하고 예외만 상위 판단으로 올리는 조직이 빠르다. Agentic Robotics의 핵심은 하나의 초지능 모델이 아니라 책임과 시간 척도가 다른 계층을 잘 연결하는 운영 설계에 가깝다.
11.5. 좋은 에이전트는 멈추고 묻는 능력이 있어야 한다
관찰이 부족하거나 사용자 의도가 모호할 때 행동을 계속하는 것은 자율성이 아니다. 논문의 루프에는 ask, observe again, stop이 정상적인 결정으로 들어 있다.
현실 환경에서는 잘못된 확신의 비용이 크다. 그래서 에이전트의 지능은 어려운 동작을 성공시키는 장면뿐 아니라 자신이 모른다는 사실을 감지하고 적절한 사람에게 넘기는 장면에서도 평가해야 한다.
12. 이 논문을 읽을 때의 한계
첫째, 이 논문은 새로운 단일 시스템을 같은 조건에서 실험한 논문이 아니다. 여러 연구의 결과를 모아 공통 언어와 로드맵을 제안한다. 표에 있는 성공률은 모델, harness, 도구, 정보, 시간 조건이 서로 달라 직접 비교할 수 없다.
둘째, 많은 높은 성능은 시뮬레이션이나 좁은 과제에서 나왔다. 실제 환경, 연속 시간, 여러 날의 기억, L3·L4 수준의 책임은 아직 충분히 측정되지 않았다.
셋째, S0·S1·S2의 경계는 구현 부품이 아니라 기능적 역할이다. 하나의 모델이 여러 역할을 할 수도 있고 하나의 역할이 여러 모듈에 걸칠 수도 있다. 이 분류는 설계를 이해하는 유용한 지도지만 자연법칙처럼 고정된 세 층은 아니다.
넷째, 논문의 출발점에는 GPT-6 Astra의 2026년 성과가 크게 자리 잡고 있다. 특정 모델의 빠른 발전이 패러다임 전환을 촉발했다는 역사적 설명과, 앞으로 모든 로봇이 같은 구조로 수렴한다는 예측은 구분해 읽어야 한다.
그럼에도 이 논문의 가치는 크다. 서로 다른 로봇 연구를 모델 점수만으로 보지 않고 의도, 실행, 검증, 시간, 비용, 책임이라는 공통 질문 위에 놓아 비교할 언어를 제공하기 때문이다.
마치며: 똑똑한 두뇌에서 믿고 맡길 수 있는 시스템으로
이 논문을 읽기 전에는 Agentic Robotics를 “LLM이 로봇을 조종하는 기술” 정도로 생각하기 쉽다. 읽고 나면 중심이 달라 보인다. Foundation Model은 중요한 부품이지만 그것만으로는 부족하다.
관찰을 최신 상태로 유지하고, 도구의 한계를 명확히 하고, 빠른 제어와 느린 판단을 나누고, 실제 결과를 독립적으로 확인하고, 실패하면 안전하게 복구해야 한다. 이 전체 구조가 있어야 범용 지능이 물리적 책임으로 바뀐다.
현재 로봇은 동작과 단일 작업에서는 빠르게 발전하고 있지만, 워크플로를 조율하고 역할을 지속하는 단계에는 아직 거리가 있다. 그래서 내 결론은 다음과 같다.
Agentic Robotics의 진짜 진보는 로봇이 더 그럴듯하게 계획을 말할 때가 아니라, 현실에서 한 일을 끝까지 확인하고 더 넓은 책임을 반복해서 맡길 수 있을 때 증명된다.
참고 자료와 확인 범위
- 원문 arXiv 초록, HTML 전문: 구조, 평가 수치, 로드맵과 한계를 확인한 기준 자료다.
- Grid Robotics 공식 프로젝트 페이지: 논문의 그림과 저자 해설을 확인했다.
- Hugging Face 논문 페이지: 공개 정보와 커뮤니티 논의를 확인했다.
- 사용자가 제공한 한국어 참고 글: 제목이 강조하는 관찰·추론·행동·검증의 흐름을 글의 설명 순서에 반영했다. 현재 환경에서는 페이지 본문을 직접 대조하지 못했다.
- alphaXiv 해설, ExplainX 리뷰, Awesome Robot Use Agent 정리: 다른 공개 요약이 강조하는 지점을 원문과 대조했다. 독립 재현 연구로 간주하지 않았다.
이 글에 사용한 그림 7개는 Grid Robotics의 논문 및 저자 공식 프로젝트 페이지에서 가져왔다. 원문의 CC BY 4.0에 따라 저자와 출처를 표시했으며, 그림의 내용은 임의로 다시 그리지 않고 원형을 유지했다. 한국어 설명과 인사이트는 원문을 바탕으로 한 나의 해석이다.