Search results
Autodev 논문 리뷰 — 코드를 쓰는 ai에서 실행하고 검증하는 에이전트로
posted on 20 Sep 2026 under category research
먼저 결론: 더 좋은 답변보다 중요한 것은 실행 결과를 다시 읽는 구조다
AI에게 코드를 부탁하면 그럴듯한 답은 금방 나온다. 그러나 그 코드를 저장하고, 테스트를 실행하고, 오류를 복사해 다시 질문하는 일은 여전히 별도의 작업이다. AutoDev는 이 반복을 개발 환경 안으로 가져온 연구다. 코드를 생성하는 모델 자체보다, 모델이 행동하고 결과를 확인하는 절차를 설계한다.
이 글에서 다룰 논문은 Microsoft 연구진 Michele Tufano, Anisha Agarwal, Jinu Jang, Roshanak Zilouchian Moghaddam, Neel Sundaresan의 AutoDev: Automated AI-Driven Development다. 2024년 3월 13일 공개된 v1 원문을 기준으로 읽는다. Hugging Face 소개 페이지에서 출발해 관련 블로그와 유튜브도 찾아 비교했다.
나의 평가는 이렇다. AutoDev는 실행 피드백을 연결한 개발 에이전트의 유용성을 보여 주지만, 대규모 저장소를 자율적으로 유지보수하는 AI 개발팀이 완성됐음을 입증하지는 않는다. 특히 “코드 생성 Pass@1 91.5%”, “테스트 커버리지 99.3%”, “멀티 에이전트”라는 표현은 각각 조건을 붙여 읽어야 한다.
이 글은 원문과 공개 리뷰를 분석한 글이며, AutoDev를 직접 실행하거나 성능을 재현한 실험 보고서는 아니다. 유튜브는 제목과 공개 소개를 확인했지만 전체 자막을 확보하지 못했다. 따라서 영상을 전부 시청한 것처럼 발언을 인용하지 않으며, 기술적 설명과 수치는 원문에 근거한다.
1. 코드 자동완성과 개발 에이전트는 무엇이 다른가
일반적인 코드 제안 도구를 “다음에 쓸 문장을 알려 주는 조언자”라고 생각해 보자. AutoDev의 목표는 조언에 그치지 않고 저장소에서 허용된 일을 수행하는 작업자를 만드는 것이다.
예를 들어 사용자가 “이 함수의 테스트를 작성하고 통과하는지 확인해 줘”라고 요청한다. 에이전트는 파일을 읽고 테스트를 작성한다. 실행 결과가 실패라면 로그를 읽고, 필요한 코드를 더 찾아보고, 테스트나 구현을 수정한 뒤 다시 실행한다. 사람이 매번 로그를 붙여 넣지 않아도 실행 결과가 다음 판단의 입력으로 돌아온다. 이것이 논문의 중심인 피드백 루프다. 원문 §1·§2
핵심 흐름은 다음과 같다.
목표 → 행동 제안 → 권한·형식 검사 → 도구 실행 → 결과 관찰 → 수정 또는 종료
여기서 “스스로 검증한다”는 말을 “자기 답이 옳다고 말한다”와 혼동하면 안 된다. 실행 환경에서 실제 오류나 테스트 결과를 받아야 피드백에 의미가 생긴다. 다만 테스트 자체가 잘못됐거나 불완전하다면, 그 결과 역시 완벽한 정답은 아니다. 이 문제는 뒤에서 다시 살펴본다.
2. 구조를 그림으로 읽기
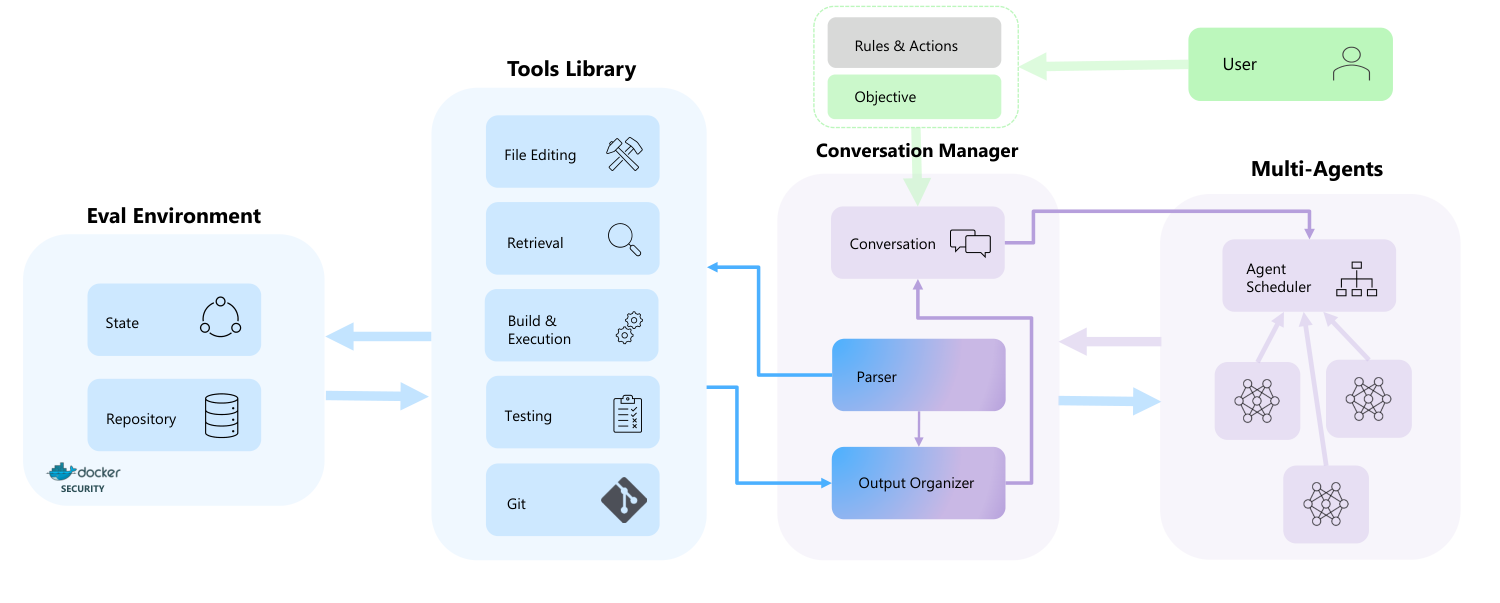
그림의 상자 이름보다 “누가 무엇을 책임지는가”에 집중하면 이해하기 쉽다.
| 구성 요소 | 책임 | 필요한 이유 |
|---|---|---|
| Conversation Manager | 대화 기록 관리, 명령 해석·검사, 결과 정리, 종료 판단 | 모델의 자유로운 답변을 실행 가능한 절차로 연결한다 |
| Agent Scheduler | 에이전트의 실행 순서와 협업 방식 결정 | 여러 역할을 사용할 때 다음에 누가 행동할지 정한다 |
| Tools Library | 파일 편집·검색·빌드·실행·테스트·Git 기능 제공 | 모델이 실제 저장소에 접근할 수 있게 한다 |
| Evaluation Environment | Docker 환경에서 작업을 실행하고 상태·출력 반환 | 제안한 코드가 실행되는지 확인하는 장소다 |
사용자는 YAML 설정으로 사용할 명령과 권한을 정한다. 명령을 해석하는 Parser는 인자와 형식, 에이전트의 권한 등을 검사한다. 파싱이 실패하면 저장소 작업을 수행하는 대신 오류를 대화에 돌려준다. Output Organizer는 실행 결과에서 중요한 상태와 오류를 정리해 다음 판단에 전달한다. 원문 §2.1–§2.2
종료도 설계의 일부다. 에이전트의 stop, 반복·토큰 한도, 실행 환경 문제 등이 중단 조건이 된다. 스케줄러는 순차 실행인 Round Robin, 작업을 마쳤다는 토큰을 넘기는 방식, 우선순위 방식을 지원한다. 여기서 스케줄링의 “token-based”는 API 요금에 쓰는 텍스트 토큰과 구분해야 한다. 원문 §2.2.3–§2.3
내가 이 구조에서 중요하게 보는 부분은 실행 권한과 모델의 의도를 분리했다는 것이다. 모델이 push를 제안하는 것과, 시스템이 실제 push 권한을 주는 것은 다른 문제다. 논문 역시 로컬 커밋만 허용하거나 원격 push까지 허용하는 식의 권한 구성을 설명한다. 다만 설계에 이런 장치가 있다는 사실과 모든 공격 상황에서 안전하다는 증명은 별개다.
3. 작은 예시: 실패한 테스트를 고치면 항상 좋은 것일까
논문 §5.1에는 HumanEval의 is_bored 문제로 테스트를 생성하는 사례가 나온다. 문장 중 I 로 시작하는 문장의 수를 세는 함수다. 다음 입력을 보자.
I am bored. This is boring!
문장은 두 개지만 I 로 시작하는 문장은 하나다. 에이전트는 처음에 기대값을 2로 작성했다가, 실행 결과와 함수의 의미를 확인하고 1로 수정한다. 이 사례는 실행 결과를 통해 자신이 만든 테스트의 오류를 교정하는 과정을 보여 준다. 원문 §5.1
그런데 여기에는 중요한 전제가 있다. 이 실험은 사람이 작성한 참조 구현에 대한 테스트 생성이다. 실무에서 구현도 AI가 작성하고 테스트도 같은 AI가 작성한다면 상황이 달라진다. 잘못된 구현에 맞춰 기대값을 바꿔도 초록색 체크가 뜰 수 있다.
따라서 내 해석은 “실패하면 테스트를 고쳐라”가 아니다. 어느 쪽이 잘못됐는지 판정할 독립적인 기준이 필요하다는 것이다. 요구사항, 사람이 유지하는 회귀 테스트, 에이전트가 수정할 수 없는 검증 세트가 그 기준이 될 수 있다. 실패 로그는 관찰 결과이지, 의도한 동작을 자동으로 알려 주는 명세가 아니다.
4. 실제로 무엇을 실험했는가
논문은 HumanEval의 164개 Python 문제를 이용한다. 각 문제는 함수 서명과 설명, 사람이 작성한 구현·테스트로 구성되며, 평균 테스트 수는 7.7개다. 실제 기업 저장소의 수개월치 이슈를 해결한 실험이 아니라 상대적으로 작은 함수 단위 벤치마크다. 원문 §3
실험은 두 종류다.
- 코드 생성: 함수 서명과 설명으로 함수 본문을 만들고, 사람이 작성한 테스트를 모두 통과하는지 확인한다.
- 테스트 생성: 사람이 작성한 정답 구현을 주고 기존 테스트는 제거한다. 새 테스트가 통과하면서 대상 함수를 호출하는지 확인하고 커버리지도 측정한다.
주요 정량 실험의 설정은 GPT-4 gpt-4-1106-preview 에이전트 하나다. 파일 편집·검색·테스트를 허용하며, 사람에게 추가 질문하는 ask는 비활성화한다. 처음 목표를 준 이후 사람의 도움 없이 작업하게 한 것이다. 여러 에이전트가 들어간 구조도와 달리, 이 점수는 멀티 에이전트 팀의 효과를 분리해 검증한 결과가 아니다. 원문 5쪽 AutoDev Settings
5. 성능 표: 숫자보다 먼저 분모와 조건을 보자
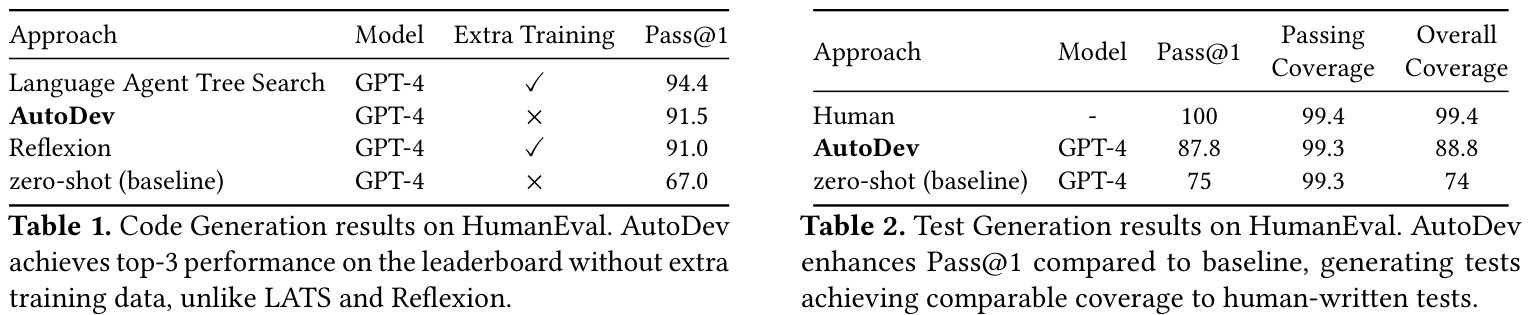
5.1 코드 생성: Pass@1은 ‘한 번 답하기’가 아니다
| 방법 | 원문에 보고된 코드 생성 Pass@1 |
|---|---|
| LATS | 94.4% |
| AutoDev | 91.5% |
| Reflexion | 91.0% |
| GPT-4 zero-shot | 67.0% |
AutoDev에서 한 attempt는 여러 번의 모델 호출, 코드 작성, 실행, 수정을 포함하는 전체 대화 세션이다. 따라서 91.5%를 “첫 코드 출력이 맞을 확률”로 해석하면 안 된다. 한 세션 안에 재시도가 들어 있다. 반면 zero-shot은 일반적으로 한 번의 추론으로 답을 생성한다. 원문 §3·§4, Table 1
비교 조건도 균일하지 않다. 논문의 코드 생성 baseline 67.0%는 GPT-4 기술 보고서에서, LATS·Reflexion 점수는 2024년 3월의 리더보드에서 가져왔다. 동일한 모델 스냅샷과 실행 예산으로 모두 다시 측정한 통제 실험은 아니다. 그러므로 “실행·수정 루프를 붙인 시스템이 좋은 결과를 보였다”는 근거로 읽되, 그 차이 전부가 AutoDev만의 설계 덕분이라고 단정하기는 어렵다.
참고로 논문 본문은 67%에서 91.5%로의 증가를 약 30%의 상대 향상이라고 적는다. 표의 값으로 직접 계산하면 +24.5%p, 상대 향상 약 36.6%다. 계산 표현에 불일치가 있어 여기서는 원래 점수와 계산값을 구분한다. Reflexion과의 0.5%p 차이 역시 표 하나로 통계적으로 의미 있는 우위라고 말할 수 없다.
표의 Extra Training도 주의할 부분이다. 이를 “Reflexion은 모델을 추가 파인튜닝한다”로 옮기면 부정확하다. Reflexion 원논문은 가중치를 갱신하지 않고 언어적 피드백과 기억을 사용하는 방법이라고 설명한다. AutoDev 표의 표시를 그대로 모델 학습 방식의 차이로 해석하지 않는 편이 안전하다.
5.2 테스트 생성: 99.3%만 떼어 읽으면 안 된다
| 방법 | 테스트 생성 Pass@1 | 통과한 테스트의 커버리지 | 전체 커버리지 |
|---|---|---|---|
| 사람이 작성한 테스트 | 100% | 99.4% | 99.4% |
| AutoDev | 87.8% | 99.3% | 88.8% |
| GPT-4 zero-shot | 75.0% | 99.3% | 74.0% |
위 수치는 원문 Table 2의 보고값이다. 테스트 생성 baseline은 저자들이 같은 GPT-4 모델로 평가했다. 99.3%는 성공한 테스트에 한정한 Passing Coverage이고, 실패를 포함하는 Overall Coverage는 88.8%다. “전체 문제에서 인간과 같은 수준의 99.3%를 달성했다”는 설명은 조건을 빠뜨린다. 원문 §4, RQ2
또 커버리지는 코드의 얼마나 많은 부분을 실행했는지 알려 줄 뿐, 잘못된 결과를 얼마나 잘 잡아내는지와 같지 않다. 대상 함수를 호출하지만 결과를 충분히 확인하지 않는 테스트도 있을 수 있다. 따라서 나에게 다음 연구 질문은 “커버리지가 높은가?”에서 끝나지 않는다. 의도적으로 버그를 넣는 mutation testing에서 얼마나 잡아내는가, 숨겨 둔 경계 사례도 검증하는가? 이 논문에 보고된 지표만으로 그 질문에 답할 수는 없다.
6. 실행을 반복하면 비용은 어떻게 되는가
논문은 코드 생성에서 평균 약 5.5개, 테스트 생성에서 약 6.5개의 명령을 사용했다고 보고한다. 대화 길이는 각각 약 1,656토큰과 1,863토큰이며, 비교용 zero-shot 값은 코드 생성 약 200토큰, 테스트 생성 373토큰이다. 코드 생성 baseline의 토큰 수는 추정값이다. 원문 §4, RQ3
여기서 대화 길이를 곧바로 API 청구량으로 바꾸면 안 된다. 매 호출에 이전 기록을 다시 넣는지, 입력과 출력을 어떻게 계산하는지, 캐시가 있는지에 따라 누적 비용이 달라진다. 이 숫자만으로 “문제당 비용이 얼마다” 또는 “개발 시간이 몇 배 줄었다”고 결론 내릴 수 없다.
내가 실무 도입을 평가한다면 성공률과 함께 다음을 기록하겠다.
- 최종 검증을 통과한 작업 하나당 누적 모델 비용과 실행 시간
- 사람이 검토하고 수정하는 데 걸린 시간
- 허용된 파일 범위를 벗어난 변경 및 기존 기능의 회귀
- 실패한 작업에 쓴 비용, 중단 조건의 작동 여부
에이전트가 다섯 번 시도해 성공하는 것이 사람이 한 번 고치는 것보다 유리한지는 작업마다 다르다. 중요한 것은 호출 횟수 자체가 아니라 검증 가능한 결과를 얻는 총비용이다.
7. 관련 블로그와 유튜브는 어떻게 읽으면 좋을까
아래 자료는 AutoDev가 등장했을 때 어떤 관점으로 소개됐는지 이해하는 데 도움이 된다. 다만 소개 글과 영상의 기대를 실험 결과와 동일시하지 않도록 원문을 함께 보는 편이 좋다.
| 자료 | 읽을 때 유용한 관점 | 원문과 함께 확인할 점 |
|---|---|---|
| Qiita — to3izo의 AutoDev 소개 | Devin 등장 당시의 맥락과 개발자 역할 변화에 대한 입문 | 폭넓은 활용 가능성과 실제 Python 함수 벤치마크를 구분하기 |
| SereniSoft — Microsoft AutoDev: Automated AI-Driven Development | 도구·협업·개발 자동화의 활용 시나리오 | 시스템이 지원하는 기능과 정량 평가된 기능은 다름 |
| The Moonlight — AutoDev 리뷰 | 구성 요소를 빠르게 훑는 AI 요약 | 독립적인 재현 실험이나 성능 검증 자료는 아님 |
| TheAIGRID — Microsoft NEW AI Agents ARMY Is Here! Fully Autonomous SOFTWARE DEVELOPERS (AutoDev) | AutoDev를 소개하는 관련 유튜브 영상 | 제목의 ‘에이전트 군단’과 단일 에이전트로 수행한 주요 실험을 구분하기 |
영상의 전체 자막을 확보하지 못했으므로 내용별 요약이나 특정 발언 평가는 하지 않았다. 위 영상은 추가 시청 자료로 제공하며, 이 글의 수치 해석은 논문에 근거한다. 또한 검색에서 나오는 모든 AutoDev 저장소가 이 논문의 공식 구현은 아니다. 같은 이름의 별도 프로젝트와 혼동하지 않도록 논문 제목·저자·arXiv ID를 함께 확인해야 한다.
8. 나의 평가: 가능성은 크지만, ‘자율성’보다 검증 체계가 먼저다
실행 결과를 얻기 쉬운 문제에서는 설득력이 있다
앞서 읽은 TradingAgents에서는 여러 역할의 토론이 좋은 투자 성과를 보장하는지 질문했다. AutoDev의 개발 문제는 상대적으로 유리한 점이 있다. 문법 오류, 빌드 실패, 특정 입력의 출력 같은 피드백을 짧은 시간 안에 얻을 수 있기 때문이다. 시장의 미래 수익보다 더 직접적으로 관찰 가능한 신호다.
하지만 테스트 통과도 요구사항 충족의 대리 지표다. 보안, 성능, 유지보수성, 사용자 경험까지 한 번에 보장하지 않는다. 피드백이 존재하는 것과, 그 피드백이 목표를 충분히 대표하는 것은 다른 문제다. 나는 이것이 AutoDev를 실무로 가져올 때 가장 중요한 경계라고 생각한다.
멀티 에이전트는 검증할 가설이지 자동으로 붙는 성능 향상이 아니다
논문은 개발자와 리뷰어 역할의 예비 협업 사례를 논의하지만, 주요 성능 표는 단일 에이전트다. 여러 역할이 단일 에이전트보다 얼마나 나은지, 같은 비용으로 비교해도 나은지는 추가 실험이 필요하다. 원문 §5.2
내가 후속 실험을 설계한다면 단일 에이전트와 개발자·리뷰어 두 에이전트에 같은 총예산을 주겠다. 최종 정답률뿐 아니라 발견한 회귀와 중복 작업도 비교하겠다. 역할을 늘리는 것보다 좋은 테스트를 보강하는 편이 효과적인 작업도 있을 것이다.
Docker는 출발점이지 완성된 보안 경계라는 증거는 아니다
Docker 격리와 명령 권한 검사는 의미 있는 장치다. 그러나 이 논문은 악성 저장소 지시, 비밀정보 유출, 위험한 마운트 설정 등 여러 공격 시나리오를 정량 검증한 보안 논문이 아니다. “Docker를 썼다”는 이유만으로 운영 환경에서 안전하다고 일반화해서는 안 된다.
이것은 논문 결과가 아니라 나의 도입 원칙이다. 처음에는 비밀정보 없는 격리 환경, 제한된 네트워크와 쓰기 경로, 에이전트가 수정할 수 없는 검증 테스트로 시작하겠다. 코드 변경과 로컬 검증은 자동화하더라도, 원격 push·병합·배포 같은 외부 영향이 있는 작업에는 별도의 승인 경계를 두는 편이 낫다.
현실적인 첫 적용 대상은 범위가 작은 유지보수다
명세가 분명한 함수 테스트, 재현 가능한 버그 수정, 특정 API 변경에 따른 제한적 수정처럼 완료 조건이 선명한 작업부터 적용할 가치가 있다. 반대로 요구사항이 모호하거나 외부 서비스·데이터 변경이 많은 작업은 사람이 의도를 정하고 위험을 판단해야 한다.
논문이 제안하는 IDE·CI/CD·PR 연계 가능성도 흥미롭지만, 그것을 실제 조직의 전체 개발 생명주기에서 검증한 결과로 읽어서는 안 된다. 원문의 통합 논의와 향후 계획은 벤치마크 성적과 구별할 필요가 있다. 원문 §5.3–§5.4
마무리: 이 논문에서 가져갈 세 가지
- 좋은 개발 에이전트는 모델만이 아니라 실행·관찰·수정 절차로 만들어진다. AutoDev의 핵심은 도구와 피드백을 연결한 구조다.
- 91.5%는 전체 세션의 성공률이고, 99.3%는 통과한 테스트의 커버리지다. 평가 조건을 빼면 숫자의 의미가 달라진다.
- 실무 성과는 테스트의 신뢰성, 권한 경계, 총비용까지 봐야 한다. 이 논문은 중요한 가능성을 보여 주지만, 개발자 대체나 자율 개발팀의 완성을 입증한 것은 아니다.
2024년의 연구를 지금 읽는 이유는 당시 리더보드 순위를 현재 성능으로 받아들이기 위해서가 아니다. 개발 에이전트를 평가할 때 “얼마나 자신 있게 답하는가”보다 “어떤 환경에서 무엇을 실행했고, 무엇으로 결과를 검증했는가”를 물어야 한다는 기준을 얻기 위해서다.
참고 자료
- Tufano et al., AutoDev: Automated AI-Driven Development, arXiv:2403.08299v1, 2024. 구조·실험 설정·수치의 1차 출처.
- Hugging Face 논문 페이지.
- Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning. 추가 학습과 언어적 피드백의 구분을 확인할 자료.
- Qiita 소개, SereniSoft 소개, Moonlight 요약, TheAIGRID 영상.
본문의 두 이미지는 CC BY 4.0으로 공개된 AutoDev v1의 그림·표 영역을 발췌해 PNG로 변환한 것이다. 한국어 해설과 비판적 평가는 이 글에서 별도로 작성했다.