Search results
Mixtral of experts 논문 리뷰 — 8명의 전문가 중 2명만 일한다는 것
posted on 13 Sep 2026 under category research
시작하며: 큰 모델의 능력을 매번 전부 계산해야 할까
모델이 커지면 저장할 가중치도 많아지고 토큰 하나를 처리하는 계산도 늘어난다. 그런데 모든 입력에 모든 파라미터를 사용할 필요가 있을까? 입력에 맞는 일부 경로만 실행하면서, 전체 모델에는 더 많은 파라미터를 둘 수 있지 않을까?
Mixtral은 모델의 전체 용량과 토큰당 실행하는 계산을 분리해 확장한다. 이를 위해 트랜스포머의 feed-forward network, 줄여서 FFN을 여러 개 두고 매 토큰마다 일부만 선택한다. Sparse Mixture of Experts, 즉 희소 전문가 혼합 구조다.
리뷰 대상은 Albert Q. Jiang 외 Mistral AI 연구진의 Mixtral of Experts다. 모델 발표는 2023년 12월 11일, 논문 공개는 2024년 1월 8일이다. 아래 성능 수치는 당시 Mixtral 8x7B 논문의 결과이며, 현재 모델들의 순위를 뜻하지 않는다.
함께 참고할 영상은 Yannic Kilcher의 Paper Explained, Kavishka Abeywardana의 3분 설명, LLMPaperReview의 한국어·영어 자막 표기 리뷰다. 세 영상의 공개 제목과 설명을 확인했고 첫 영상의 챕터를 읽기 순서에 참고했다. 다만 자막 요청이 빈 응답을 반환해 전체 발언은 확인하지 못했다. 따라서 특정 발표자의 견해로 단정하지 않고, 기술 설명과 수치는 원논문·공식 자료에 근거해 정리했다.
1. 전문가 8개는 완성된 챗봇 8개가 아니다
일반적인 decoder Transformer 블록을 간단히 보면, attention으로 다른 위치의 정보를 모으고 FFN으로 각 위치의 표현을 변환한다. 정규화와 잔차 연결은 이 두 연산을 둘러싼다.
일반 블록: attention → 하나의 FFN
Mixtral:   attention → router → 선택된 FFN 2개 → 가중합
Mixtral이 바꾸는 부분은 FFN이다. 각 층에 서로 다른 가중치를 가진 FFN 8개를 두며 이를 expert라고 부른다. attention은 해당 층의 공통 경로로 남는다. 문장 전체를 “수학 챗봇”이나 “코딩 챗봇”에 전달하는 서비스 라우터와는 동작 단위가 다르다.
선택은 각 토큰의 각 층에서 일어난다. 같은 토큰도 다음 층에서는 다른 전문가를 사용할 수 있고, 같은 층에서도 옆 토큰은 다른 전문가로 갈 수 있다. expert 3이라는 번호가 모든 층에 걸쳐 하나의 공유 전문가를 가리키는 것도 아니다. 원논문 §2
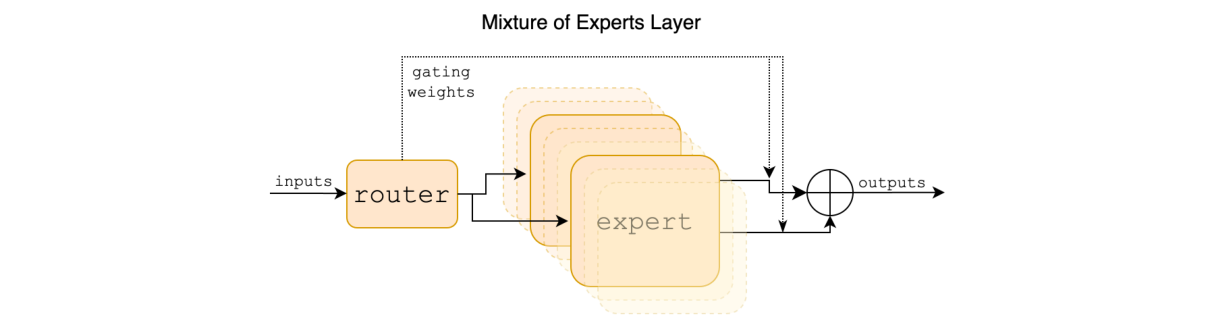
이 그림의 출력은 두 챗봇이 만든 문장에 대한 투표가 아니다. 전문가가 반환한 은닉 벡터를 가중합한 뒤 다음 층으로 넘기는 것이다. 실제 다음 토큰의 확률은 모델의 마지막 출력 단계에서 계산한다.
2. Router는 무엇을 보고 두 전문가를 고를까
router가 받는 x는 그 위치의 현재 은닉 표현이다. 앞선 attention과 층들을 거쳤으므로 문맥 정보가 들어 있다. 간단한 선형층으로 전문가별 점수 8개를 계산하고, 상위 2개만 남겨 softmax로 정규화한다.
logits = x × W_router
weights = softmax(top2_mask(logits))
y = Σ weights[i] × expert_i(x)
여기서 top2_mask는 선택되지 않은 점수를 음의 무한대로 만드는 연산이다. 0으로 바꾸면 softmax에서 양의 비중이 생길 수 있어 같은 계산이 아니다. 선택되지 않은 전문가의 가중치는 0이므로 해당 FFN의 실행을 생략할 수 있다. 원논문 §2.1
숫자로 보면 더 간단하다. 다음은 실제 모델 로그가 아닌 설명용 예제다.
전문가 점수: [0.2, 2.0, -0.4, 0.5, 1.0, 0.1, -0.2, 0.3]
선택:        expert 1과 expert 4   (번호는 0부터 시작)
혼합 비율:   softmax([2.0, 1.0]) ≈ [0.731, 0.269]

expert 1의 출력이 [2, 0], expert 4의 출력이 [0, 4]라면
최종 출력 ≈ 0.731 × [2, 0] + 0.269 × [0, 4]
          = [1.462, 1.076]
router는 정답을 미리 확인하고 더 잘 답한 전문가를 고르지 않는다. 현재 표현으로 경로를 선택하는 법을 학습한다. 공식 발표는 router와 전문가를 함께 학습한다고 설명한다. Mistral AI 발표
각 전문가는 SwiGLU FFN이다. 단순화하면 두 선형 변환 중 하나에 SiLU 활성함수를 적용하고, 두 결과를 원소별로 곱한 다음 출력 projection을 적용한다. 이 내부 gate와 전문가를 선택하는 router는 서로 다른 연산이다.
3. 왜 8×7B인데 56B가 아니라 46.7B일까
모델 이름만 보면 7B 모델 8개를 통째로 붙였다고 생각하기 쉽다. 하지만 expert마다 복제되는 것은 FFN이고 attention 등은 공유한다. 그래서 전체 파라미터는 단순한 8 × 7B가 아니다.
공식 발표의 더 정확한 표기는 전체 약 46.7B, 토큰당 활성 약 12.9B다. 논문의 47B와 13B는 이를 반올림한 값이다. 공식 발표
논문 Table 1과 공식 모델 설정을 이용하면 규모를 손으로 확인할 수 있다. 모델 폭은 4,096, FFN 중간 폭은 14,336이고 층은 32개다. SwiGLU에는 주요 행렬 세 개가 있으므로 다음처럼 근사한다.
한 층의 전문가 한 개:
3 × 4,096 × 14,336 ≈ 0.176B

모든 전문가의 FFN 가중치:
32층 × 8개 × 0.176B ≈ 45.1B

토큰 하나가 사용하는 FFN 가중치:
32층 × 2개 × 0.176B ≈ 11.3B
여기에 공통 attention, embedding, 출력층, router 등을 더하면 약 46.7B와 12.9B가 된다. 작은 정규화 항 등을 생략한 규모 확인용 계산이다. 따라서 “2개만 쓰니까 14B”라는 계산도 정확하지 않다.
| 숫자 | 무엇을 말하나 | 무엇까지 보장하지는 않나 |
|---|---|---|
| 8 experts | 층마다 보유한 FFN 수 | 독립된 7B 챗봇 8개 |
| Top-2 | 토큰·층마다 실행할 전문가 수 | 요청 전체가 같은 두 전문가만 사용 |
| 약 46.7B | 전체 가중치 규모 | 필요한 GPU 메모리 전체 |
| 약 12.9B active | 토큰당 실행 경로의 파라미터 규모 | 모든 장비에서 dense 13B와 같은 속도 |
4. 계산은 희소해져도 메모리와 통신은 남는다
한 토큰에서 선택하지 않은 전문가도 다음 토큰이나 다른 요청에서는 필요할 수 있다. 일반적인 상주 방식으로 실행하려면 전체 가중치를 장치에 보관해야 한다. offloading을 쓰면 장치 메모리를 줄일 수 있지만 전송 비용을 지불한다.
BF16 가중치만 단순 계산하면 46.7 × 10⁹ × 2 bytes ≈ 93.4 GB다. 이는 십진 GB 기준의 가중치만의 이론적 크기다. 실제 실행에는 KV cache, 활성값, 임시 버퍼 등이 추가되며 양자화 방식에 따라서도 달라진다. 12.9B만 메모리에 올리면 된다는 의미가 아니다.
전문가를 여러 GPU에 나누는 expert parallelism에서는 토큰 표현을 해당 전문가가 있는 GPU로 보내고, 출력은 원래 위치로 돌려보낸다. 특정 전문가에 요청이 몰리면 다른 장치가 놀더라도 그 장치가 병목이 될 수 있다. 큰 배치에서는 여러 전문가가 동시에 쓰이므로 “활성 전문가가 2개”라는 말은 배치 전체의 활성 전문가 수를 뜻하지 않는다. 원논문 §2.1 및 §3의 Size and Efficiency
MegaBlocks는 전문가마다 배정된 토큰 수가 달라지는 계산을 block-sparse 연산으로 다루는 관련 시스템 연구다. MoE가 실제로 빨라지려면 이런 커널과 데이터 배치 방식이 함께 필요하다.
그래서 나는 활성 파라미터가 적다는 것을 비용 절감의 출발점으로 읽고, 최종 속도 측정값으로 읽지는 않으려 한다. 긴 입력에서는 attention과 KV cache의 비용도 중요하다. FFN 비용이 언제나 모델 전체를 압도한다고 가정하면 긴 문서 처리에서 판단을 잘못할 수 있다.
5. 논문 결과: 어떤 지표에서 강했는가
아래는 원논문 Table 2에서 골라 옮긴 값이다. 별도 재실험이나 현재 모델 비교가 아니다. 수학 과제에는 논문이 밝힌 다중 생성·다수결 조건이 들어 있으므로, 다른 표나 리뷰의 단일 생성 점수와 섞어 읽지 않아야 한다.
| 지표 | Llama 2 70B | Mixtral 8x7B | 관찰 |
|---|---|---|---|
| MMLU | 69.9% | 70.6% | 비슷한 수준 |
| HumanEval | 29.3% | 40.2% | 코드 생성에서 높은 값 |
| MBPP | 49.8% | 60.7% | 이 평가 설정에서도 코드 강점 |
| MATH | 13.8% | 28.4% | 수학에서 큰 차이 |
| GSM8K | 69.6% | 74.4% | 다수결 평가 조건의 결과 |
| HellaSwag | 85.4% | 84.4% | Mixtral이 낮은 항목도 존재 |
| WinoGrande | 80.4% | 77.2% | 모든 항목의 일괄 우위는 아님 |
출처: 원논문 §3, Table 2. MATH는 4-shot·maj@4, GSM8K는 8-shot·maj@8 조건이다. MBPP는 hand-verified subset을 사용했다. maj@k는 여러 생성 결과의 다수결을 사용하는 평가 방식이다.
Table 3의 GSM8K는 5-shot 조건이라 Mixtral 점수가 58.4%로 다르다. 이를 Table 2의 74.4%와 나란히 놓고 성능이 떨어졌다고 해석하면 평가 조건을 놓친 것이다. 또한 Table 3의 MT-Bench는 Mixtral Instruct 8.30, 당시 비교 대상 GPT-3.5 8.32다. “GPT-3.5를 모든 평가에서 이겼다”는 문장보다 여러 지표에서 경쟁력 있는 성능을 보였다가 표에 충실하다. 원논문 Table 3
논문은 프랑스어·독일어·스페인어·이탈리아어 평가도 보고한다. 이것만으로 한국어 품질까지 입증됐다고 할 수는 없다. 긴 문맥에서는 32k 범위의 passkey retrieval 성공과 문맥 증가에 따른 perplexity 개선을 보였지만, 하나의 키를 찾는 합성 실험이 복잡한 문서 전체의 완벽한 이해를 보장하지는 않는다.
6. 전문가가 진짜 분야별로 나뉘었을까
내게 이 논문의 가장 흥미로운 부분은 라우팅 분석이다. “수학은 수학 전문가, 의학은 의학 전문가”라고 설명하면 직관적이지만, 연구진의 관찰은 그렇게 깔끔하지 않았다.
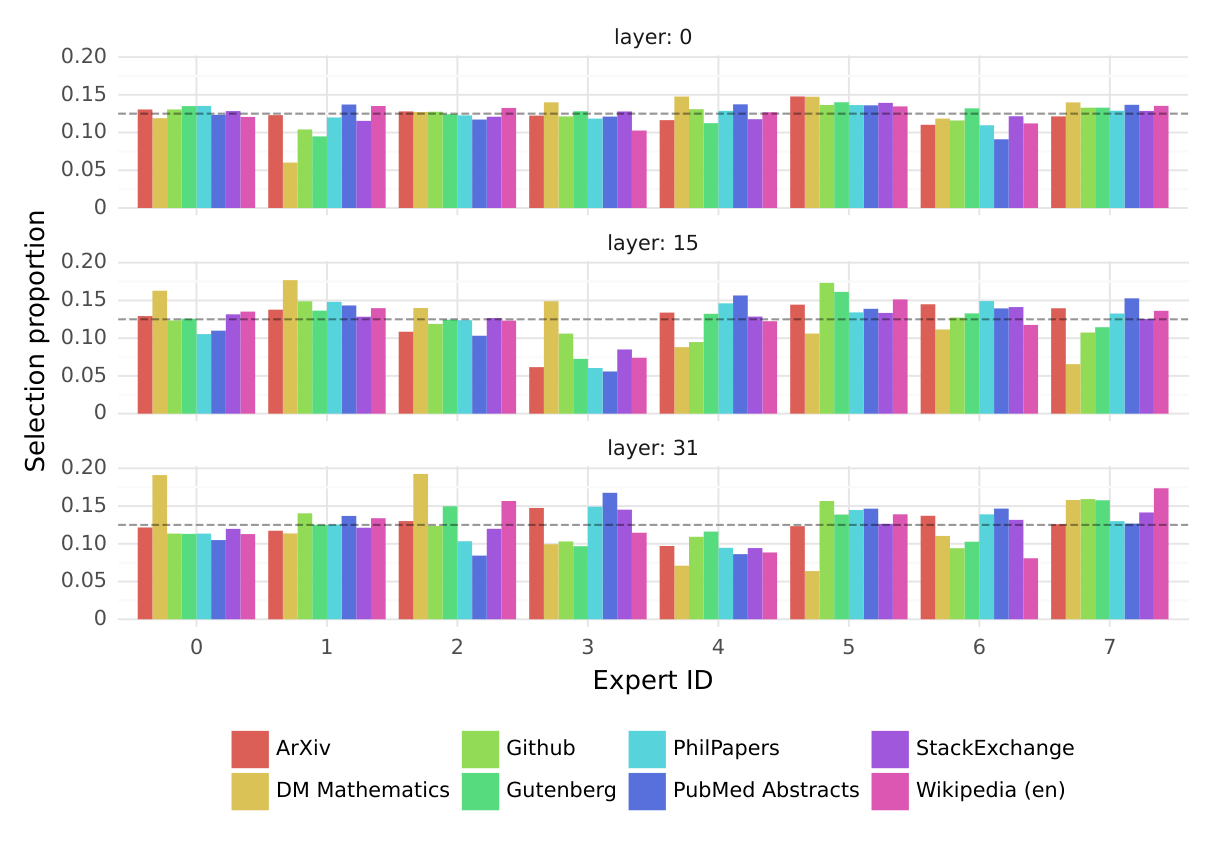
ArXiv·PubMed·철학 문서 등에서 전문가 선택 분포가 대체로 비슷했다. 합성 수학 데이터에서는 일부 차이가 있었지만, “특정 전문가는 특정 주제 전담”이라는 뚜렷한 패턴은 찾지 못했다. 이는 논문의 분석 범위에서의 관찰이며, 전문가 간 기능 차이가 전혀 없다는 증명은 아니다.
그래프 점선은 균등하게 선택될 때의 1/8 기준이다. 첫째·둘째 선택을 합친 선택 건수의 분포로 읽어야 한다. 토큰 하나가 두 전문가로 가므로, 토큰 수를 분모로 한 개별 전문가의 포함 확률 2/8과 혼동하면 안 된다.
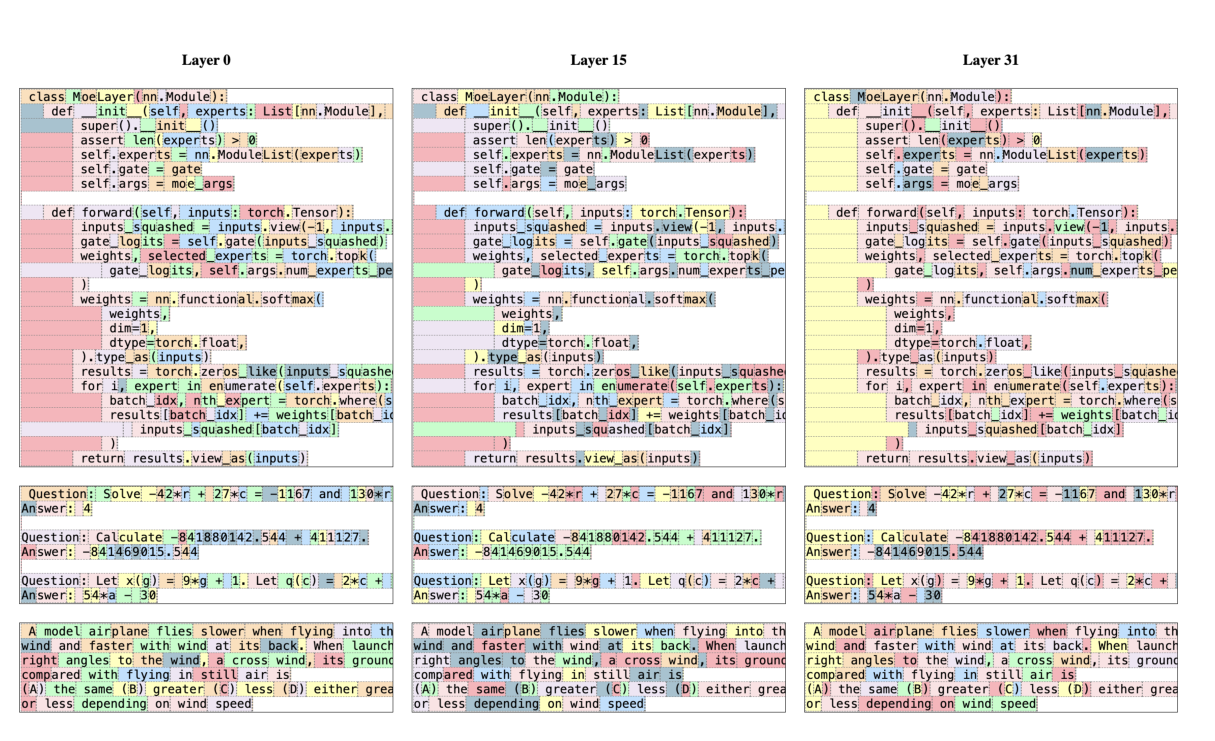
연구진은 코드의 들여쓰기나 특정 표현에서 반복적인 선택을 관찰했다. 연속한 토큰들이 같은 전문가를 선택하는 위치적 국소성도 중간·마지막 층에서 두드러졌다. 이 관찰은 주제 이름보다 구문과 표현 형태에 관련된 경향을 시사한다. 원논문 §5
내 해석으로는 expert라는 이름을 사람의 전문 직업에 너무 강하게 대응시키지 않는 것이 좋다. 각 expert는 표현을 바꾸는 학습된 계산 모듈이다. 사람이 이해하기 쉬운 학문 분류와 정확히 대응해야 할 이유는 없다.
7. 학습과 Instruct: 라우팅 구조만으로 챗봇이 완성되지는 않는다
MoE에는 특정 전문가로 학습 신호와 계산이 쏠리는 문제가 있다. 전문가 사용을 균형 있게 유도하는 것이 중요한 일반적 연구 주제이며, 이런 문제는 Mixtral 이전의 sparsely-gated MoE 연구에서도 다뤄졌다. Mixtral을 MoE 자체를 처음 발명한 논문으로 읽어서는 안 된다.
다만 이 짧은 논문은 사전학습 데이터의 전체 구성과 모든 학습 세부 설정을 재현 가능한 수준으로 공개하지는 않는다. 공식 설정 파일에 auxiliary loss 관련 항목이 있다는 이유만으로, 그것이 논문 실험의 모든 학습 조건을 설명한다고 단정하지 않겠다.
Mixtral Instruct는 base 모델에 instruction 데이터로 SFT를 하고, 선호 응답 쌍을 사용하는 DPO를 적용한 모델이다. 따라서 base 모델의 지식·코드 평가와 Instruct의 대화 평가를 구별해야 한다. 논문에 실린 Arena 순위 그림도 2023년 12월 22일의 스냅샷이다. 현재 순위처럼 받아들이면 안 된다. 원논문 §4
가중치 공개와 Apache 2.0 라이선스는 직접 실행하고 활용할 수 있게 했다는 점에서 의미가 크다. 그러나 공개 가중치와 완전히 공개된 학습 데이터·재현 절차는 같은 범위의 공개가 아니다.
8. Mamba와 연결해 보면 두 논문이 더 잘 보인다
앞서 읽은 Mamba 리뷰에서는 과거 정보를 어떤 상태로 저장하고 전달할지가 중심이었다. Mixtral은 각 위치의 표현을 변환할 때 어떤 파라미터를 실행할지를 선택한다.
| 질문 | Mamba | Mixtral |
|---|---|---|
| 주요 선택 대상 | 상태에 정보를 쓰고 읽는 방식 | FFN 전문가 경로 |
| 초점 | 시퀀스 기억과 전달의 비용 | 전체 용량과 토큰당 계산의 분리 |
| attention과 관계 | 원래 Mamba는 attention 없이 구성 | Transformer attention을 유지 |
| 남는 비용 | 상태 갱신·커널·기억 압축의 부담 | 전체 가중치·KV cache·라우팅·통신 |
따라서 Mixtral의 ‘sparse’는 attention 행렬을 희소하게 만든다는 뜻이 아니다. 원논문은 32k의 fully dense context를 지원한다고 적고, 공식 설정의 sliding_window도 null이다. Mistral 7B의 모든 특징을 이름만 보고 그대로 적용하지 않도록 주의할 부분이다. 원논문 §2, 공식 설정
9. 내가 가져갈 점: 저장한 용량과 지불하는 계산을 나눠 보기
이 논문을 읽고 나면 “몇 B 모델인가?”라는 질문 뒤에 두 가지를 더 묻게 된다. 그중 토큰 하나에 몇 B를 실행하는가? 그리고 실제 장비에서는 무엇이 병목인가?
내가 보는 Mixtral의 의의는 새로운 전문가 비유 자체보다, 더 큰 파라미터 용량을 일부 경로만 실행하는 방식으로 활용하고 공개 모델에서 강한 결과를 보여줬다는 점이다. 계산 선택이라는 아이디어를 실용적 모델과 실행 생태계로 연결했다.
반면 폐쇄망 문서 검색 같은 업무에 적용한다면 활성 파라미터만 보고 고르지는 않겠다. 가중치와 KV cache가 장비에 들어가는지, 한국어 조항 번호를 정확히 답하는지, 동시 요청에서 라우팅과 통신이 어떻게 변하는지를 확인해야 한다. 전문가가 여러 개라고 출처 검증이나 검색이 자동으로 해결되는 것도 아니다.
직접 비교 실험을 한다면 같은 질문·같은 검색 문서·같은 생성 조건에서 정답률과 근거 인용 정확도를 먼저 보고, 첫 토큰 지연·생성 속도·최대 메모리·동시 처리량을 함께 기록하겠다. 이 글의 예제와 해석은 이해를 위한 것이며 실제 Mixtral 배포 성능을 측정한 결과는 아니다.
참고 자료와 영상 읽기 순서
- Mixtral of Experts 원논문: 구조와 실험, 라우팅 분석의 기준 자료.
- Mistral AI 공식 발표: 46.7B·12.9B 표기와 공개 모델의 배경.
- 공식 모델 설정: 층 수, 폭, 전문가 수, Top-2 설정 확인.
- Yannic Kilcher — Mixtral of Experts (Paper Explained): 설명란의 챕터 기준 11:15 라우팅, 17:00 희소 라우팅, 22:00 전문가 병렬화, 31:30 라우팅 분석.
- Kavishka Abeywardana — Mixtral of Experts Explained in 3 Minutes!: 공개 설명에서 Top-K·SwiGLU·전문가 병렬화를 안내하는 짧은 입문 영상.
- LLMPaperReview — Mixtral: Mixtral of Experts: 제목에 한국어·영어 자막이 표기된 리뷰. 이 글 작성 과정에서는 자막 본문을 확보하지 못했다.
- Sparsely-Gated Mixture-of-Experts Layer, MegaBlocks: MoE의 선행 아이디어와 효율적인 실행을 이해할 후속 읽기 자료.
그림 3장은 Jiang et al.의 논문 Figure 1·7·8에서 그림 영역만 발췌했다. 논문의 CC BY 4.0에 따라 출처·저자·변경 사항을 표시했다. 모델 가중치의 Apache 2.0 라이선스와 논문 그림의 라이선스는 구별한다.